Was Kausalität wirklich bedeutet
Die meisten Menschen glauben, sie verstünden Kausalität. Sie verwechseln sie mit zeitlicher Abfolge, mit Korrelation, mit Intuition. Aber Kausalität ist eine strengere Behauptung: Sie behauptet, dass eine Veränderung in X eine Veränderung in Y bewirkt, unabhängig von allem anderen. Das Problem ist, dass diese Behauptung nicht direkt beobachtbar ist. Sie können X und Y beobachten, aber niemals die beiden Welten gleichzeitig: eine, in der X passiert ist, und eine, in dem es nicht passiert ist. Diese unbeobachtbare Welt nennen Statistiker das Gegenfaktische. Kausale Inferenz ist die Wissenschaft, aus beobachtbaren Daten Schlüsse über das Gegenfaktische zu ziehen — mit expliziten Annahmen, transparenten Methoden und quantifizierter Unsicherheit. Es ist keine Magie. Es ist Disziplin.
Die drei Hürden
Jede kausale Analyse muss drei fundamentale Probleme lösen, bevor sie zu einem validen Ergebnis kommt
Die erste Hürde ist die Selektion: Warum sind bestimmte Einheiten der Behandlung ausgesetzt und andere nicht? Die zweite ist die Verwobenheit: Welche Variablen beeinflussen sowohl die Behandlung als auch das Ergebnis? Die dritte ist die Generalisierung: Gilt das, was wir in einer Stichprobe fanden, auch in einer anderen Population? Jede dieser Hürden kann eine Analyse ungültig machen. Wir helfen Ihnen, sie systematisch zu identifizieren und methodisch zu überwinden.
Mehr erfahren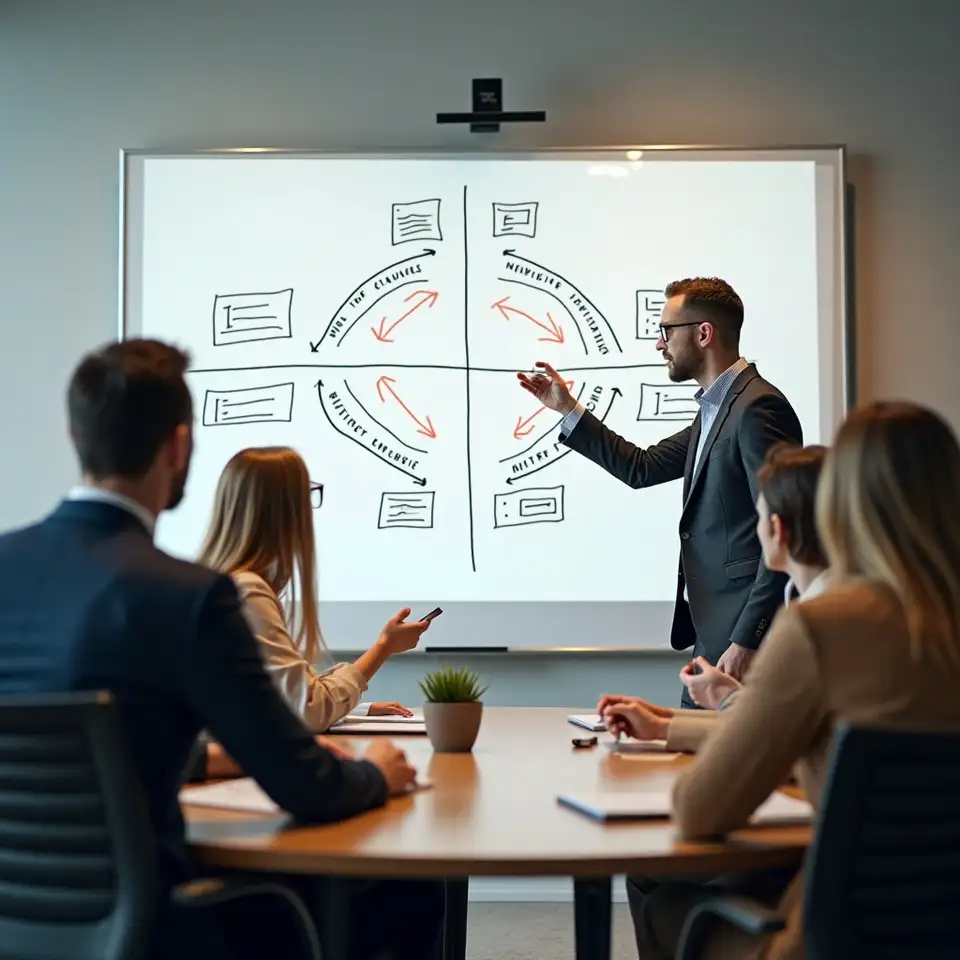
Kausale Diagramme als Werkzeug
Von der Intuition zur formalen Struktur
Das grösste Hindernis für gute kausale Analyse ist nicht die Statistik. Es ist die Unfähigkeit, die eigenen Annahmen explizit zu machen. Kausale Diagramme — gerichtete azyklische Graphen, um es formal auszudrücken — zwingen uns, diese Annahmen sichtbar zu machen. Jeder Pfeil repräsentiert eine behauptete Ursache-Wirkung-Beziehung. Jeder fehlende Pfeil repräsentiert eine ebenso wichtige Behauptung: dass kein direkter Zusammenhang besteht. Wenn Sie Ihr Problem nicht in einem solchen Diagramm darstellen können, verstehen Sie es noch nicht gut genug. Das ist unbequem. Aber es ist der erste Schritt zu einer Analyse, die unter Druck besteht.
Kein Verfahren passt zu allen Fragen. Die Kunst liegt in der Auswahl.
Methoden der kausalen Inferenz im Überblick
Die kausale Inferenz bietet ein Werkzeugkasten, nicht eine Universalwaffe. Jedes Verfahren hat seine Annahmen, seine Stärken und seine Grenzen.
Matching-Verfahren versuchen, behandelte und unbehandelte Einheiten so zu paaren, dass sie in allen relevanten Merkmalen ähnlich sind. Die verbleibenden Unterschiede im Ergebnis werden dann der Behandlung zugeschrieben.
Instrumentalvariablen nutzen eine externe Quelle der Variation, die das Ergebnis nur
über den Behandlungspfad beeinflusst. Dies erfordert eine starke Annahme, liefert aber
valide Schätzungen, wenn sie zutrifft.
Difference-in-Differences vergleicht die Veränderung über die Zeit zwischen einer
behandelten und einer Kontrollgruppe. Die zentrale Annahme ist die parallele Trends:
Ohne Behandlung hätten sich beide Gruppen gleich entwickelt.
Regressionsdiskontinuitätsdesigns nutzen scharfe Schwellenwerte, bei denen die Behandlung quasi-zufällig zugewiesen wird. Die Annahme ist, dass Einheiten knapp über und knapp unter der Schwelle vergleichbar sind.
Die ehrliche Einschätzung der Grenzen ist so wichtig wie die Methodik selbst
Wann kausale Inferenz scheitert
Nicht jedes Problem lässt sich kausal beantworten. Die Erkenntnis, dass die Daten es nicht
hergeben, ist selbst ein wertvolles Ergebnis.
Wenn alle relevanten Variablen unbeobachtet sind, kann keine statistische Methode die fehlende Information ersetzen. Die Annahme der Unbeobachtbarkeit lässt sich nicht testen.
Wenn die Behandlung nicht klar definiert ist oder sich im Laufe der Zeit verändert, wird die kausale Fragestellung selbst unklar. Präzision in der Konzeptualisierung ist unverzichtbar.
Wenn die Stichprobe zu klein ist oder die Variation in der Behandlung zu gering, werden
die Schätzungen zu unpräzise, um handlungsrelevant zu sein.
Wenn die Annahmen des gewählten Verfahrens systematisch verletzt sind, ist das Ergebnis nicht nur ungenau, sondern irreführend. Wir testen diese Annahmen rigoros.
Anwendungsbereiche kausaler Analyse
Kausale Inferenz ist keine akademische Übung. Sie wird dort eingesetzt, wo echte
Entscheidungen auf dem Spiel stehen und die Kosten falscher Annahmen hoch sind.
Gesundheitswesen
Welche Behandlung wirkt tatsächlich besser? Kausale Methoden helfen, Behandlungseffekte aus Beobachtungsstudien zu schätzen, wenn Randomisierung ethisch oder praktisch unmöglich ist. Die Annahmen müssen dabei besonders sorgfältig geprüft werden.
Risiko und Compliance
Welche regulatorischen Massnahmen reduzieren tatsächlich das Risiko? Kausale Modelle trennen die Wirkung von Interventionen von konfundierenden Faktoren wie Marktbedingungen oder Unternehmensgrösse.
Marketing und Produkt
Welche Kampagne hat den Umsatz wirklich getrieben? Kausale Inferenz unterscheidet echte Werbewirkung von Selbstselektion und saisonalen Effekten, die sonst als Erfolg fehlinterpretiert würden.
Methodisch fundiert, ehrlich kommuniziert
Unser Ansatz
Wir glauben nicht an die Illusion der Gewissheit. Jede kausale Aussage ist eine
Annahme über die Welt, die mit den verfügbaren Daten abgeglichen wird. Unsere
Aufgabe ist nicht, Ihnen das zu geben, was Sie hören wollen, sondern das, was die
Methodik hergibt. Das bedeutet manchmal, dass wir sagen müssen: Die Daten erlauben
keine klare Antwort. Das bedeutet, dass wir jede Annahme dokumentieren, jede
Unsicherheit quantifizieren und jedes Ergebnis gegen alternative Erklärungen testen.
Das ist langsamer als eine schnelle Prognose. Aber es ist der einzige Weg, zu
Entscheidungen zu kommen, die unter regulatorischer Prüfung, unter wirtschaftlichem
Druck und unter der Last der Verantwortung bestehen.
Häufige Missverständnisse in der Datenanalyse
Die grössten Fehler in der Analytics-Praxis entstehen nicht aus mangelnder Technik,
sondern aus falschen Annahmen über das, was Daten leisten können. Hier sind vier, die
wir besonders oft begegnen.
-
Korrelation impliziert Kausalität
Dies ist der klassische Fehler. Zwei Variablen können stark zusammenhängen, ohne dass die eine die andere verursacht. Ein gemeinsamer Drittfaktor, eine zeitliche Verzerrung oder reiner Zufall können die Beobachtung erklären.
-
Grosse Datenmengen ersetzen Methodik
Mehr Daten machen keine schlechte Fragestellung besser. Wenn die kausale Struktur unklar ist, führen Millionen von Datensätzen nur zu präziseren Fehlschlüssen, nicht zu besseren Entscheidungen.
-
Komplexe Modelle sind genauer
Ein Modell mit hundert Variablen ist nicht automatisch besser als eines mit zehn. Oft verschleiert zusätzliche Komplexität die zugrunde liegenden Annahmen und macht das Ergebnis weniger interpretierbar.
-
Signifikanz bedeutet Relevanz
Ein statistisch signifikanter Effekt kann praktisch bedeutungslos sein. Die Frage ist nicht, ob ein Effekt existiert, sondern ob er gross genug ist, um eine Entscheidung zu rechtfertigen.